


把剧本拆成分镜后批量生成,适合连续的 AI 短剧。
YoVoice是什么
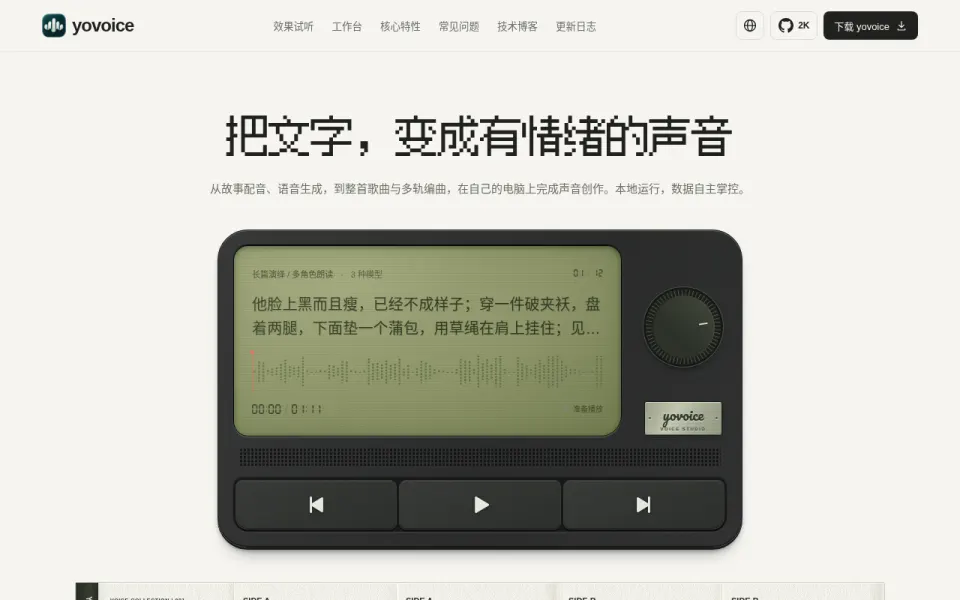
YoVoice 是一个开源的桌面音频工作室,作者是 leemysw,2026 年 9 月才开源,版本迭代很快,官网当前写到 v0.5.0。所有生成都在本机完成,只有可选的 AI 写词助手会把请求发给你自己配置的模型服务。
它把几类事放在一个界面里:文字转语音,支持用参考音频克隆声音,也可以用文字描述设计新声音;故事配音,导入文本或字幕后给每一行指派角色,逐行生成;写词作歌,按段落标记出带歌词的歌曲或纯伴奏;还有按小节和拍编曲的多轨配乐,能导入导出 MIDI。
底层集成了不少模型,如 IndexTTS、Qwen3-TTS、Kokoro、ACE-Step、Stable Audio 3 等。要注意各模型许可不同,有的只能非商用,用在商业短剧前要逐个核对。
主要功能
- 声音克隆与设计用一小段参考音频克隆声音,或者直接写文字描述来设计一个新声音。
- 故事配音导入文本或字幕,给每一行指派角色,逐行生成多角色对白。
- 写词作歌写风格和带段落标记的歌词,生成歌曲或纯伴奏,歌词随播放同步显示。
- 音频体检与响度自动查爆音、杂音和结尾突兀,并可按有声书、播客、视频的目标响度导出。
- 命令行与 MCP带命令行、HTTP 接口、MCP 服务和 Agent Skill,可让 AI 助手调用。
在 AI 短剧里怎么用
在剧本定稿之后用它做对白和配乐:先导入字幕或台词,给主要角色各挑或克隆一个声音,逐行生成并试听,不满意的句子单独重抽;片尾曲和背景音乐放在作歌和配乐页做。导出时按视频响度目标出文件,再拖进剪映或 Premiere 与画面对齐。口型对不上的镜头,另接专门的口型工具。
用户怎么说
有用户在 macOS 上装 v0.3.1,下载 IndexTTS 和 VoxCPM2 的量化模型全部报文件大小不匹配,一秒内就失败,排除了网络问题。作者回复说是 ModelScope 镜像刚更新所致,已在后续版本修复。
— 来自 GitHub 用户反馈
有用户反馈音乐生成和编曲导出音频时会超时,只能自己去生成目录里找文件。作者请他提供日志,之后该用户换到 0.4.1 版本,说问题没有了。
— 来自 GitHub 用户反馈
一位试用语音功能的用户新建了角色,不满意想删除,却在界面里找不到入口,作者回复了截图说明可以直接删除,说明这个操作藏得不太显眼。
— 来自 GitHub 用户反馈
整理自公开平台上的用户反馈,已翻译改写,不代表 TVLab 观点。
适合谁,不适合谁
适合:不想把台词和声音样本传到云端、有一台能跑模型的电脑的个人创作者
要注意:项目很新,Bug 还在修;部分模型限非商用;做歌要 12GB 以上显存,门槛不低。
常见问题
YoVoice 要什么配置?
官网给的参考:轻量朗读 4GB 以上内存;高质量克隆和声音设计需要 4 到 6GB 显存,或 8GB 以上内存的 Apple 芯片;整首歌和纯伴奏需要 12GB 以上显存,或 16GB 以上的 Apple 芯片。
YoVoice 生成的声音和歌能商用吗?
软件本身是 Apache-2.0,但输出能否商用取决于所用模型的许可。官网列出 OmniVoice、YuE2 等为非商用,Breeze TTS 2 的输出不能商用,Stable Audio 3 对年收入 100 万美元以下的机构免费。商用前请逐个核对。
YoVoice 有中文界面吗?
有。界面提供包含简体中文、繁体中文在内的 12 种语言,切换不需要重启。语音模型的语言支持各不相同,中文可选的模型有 Kokoro、Qwen3-TTS、Breeze TTS 2 等,以官网为准。
同类工具

做角色定妆图、海报和分镜参考图。
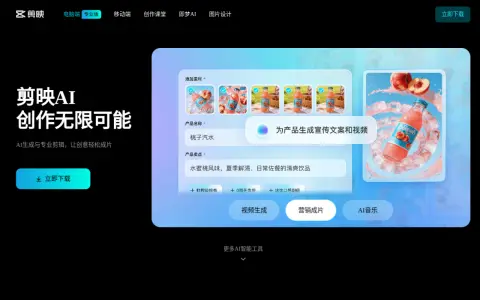

把 AI 生成的片段拼成成片,加字幕、配乐、转场。

Luma AI 的视频生成平台,自家 Ray 系列模型擅长电影感画面,可用关键帧控制镜头走向。

数字人口播与视频翻译平台,能把一段视频译成多语种并保持口型对上
腾讯开源的 8.3B 视频模型,文生视频、图生视频都能做,14GB 显存起步可本地跑
用过 YoVoice?
到 TVLab 社区说说你的用法、踩过的坑,或者问问别人怎么调参数。